ego-centric human data
ego-centric human data
1. 界定
比如说拿到了一条数据,那么判断其为ego-centric数据的标准是:相机的位姿应当与执行行为的本体一起运动
如果要采集这样的数据,应该如何做?难点在哪里?
- vla在pretrain的时候,state和action的维度是不是就应该和具体的机型对齐?现在的跨本体vla做到了哪一步?
- 如果是动态的移动的人,这个数据如何捕捉?
- wam?
Q1: Egocentric Human Data:如何从采集数据到真正投入训练?——双臂version
细想一下,这里其实可以拆分成三个问题:
- State Estimation(状态估计):人类的手、头部、物体分别在哪里,姿态是什么?
- Action Construction(动作构造):根据相邻时间点的状态,如何构造模型需要预测的动作?
- Human-to-Robot Alignment(人机对齐):构造出来的人类动作能否被机器人理解、学习乃至执行?
1. State Estimation(状态估计):
现有的三种主流的方法: 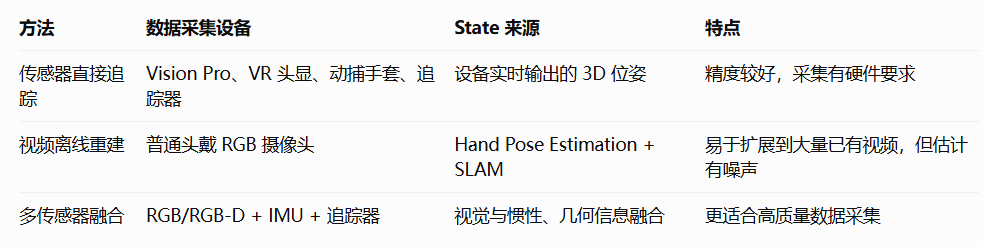
总结一下,假如说要从现有的视频中直接获得状态信息,本质上是通过重建相机
1)视频重建
related works:(以双臂操作为例) - HaMeR 和 WiLoR 可以从图像重建 MANO 手部模型;(hand pose estimation) - 通过 SLAM、视觉里程计或融合定位估计摄像头在空间中的运动(camara pose estimation) - 结合上面两点计算出在世界坐标系的位置
https://nvidia.github.io/IsaacCapture/main/ego_post_processing/egohand.html
egohand提供了一个完整的state建设链路;但需要注意至少需要相机内参等信息才能准确重建,否则因为缺少深度信息只是一个估计。然而对于几万小时scale的ego-centric
human data,互联网视频数据的转化一定是一个主要来源: 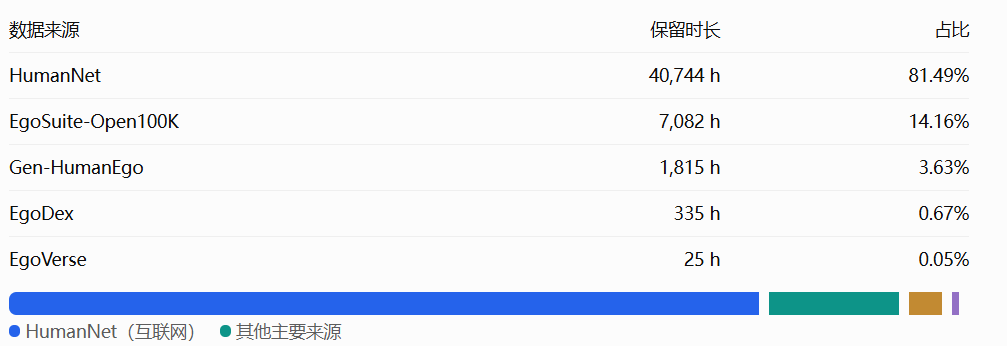
我认为暂时可以认为,即使 state/action 不完全准确,只要估计足够有用、时序足够稳定,并且数据规模足够大,那么在噪声可控的情况下模型依然可能学习到可以迁移的操作规律。
2)直接追踪
比方说,使用Apple Vision Pro这类本身具有多摄像头和 SLAM/Hand Tracking 能力的设备在采集视频时同步记录手的三维信息;又或者使用 Vive Tracker 追踪手腕,加上 Manus 等动捕手套测量手指动作(Egoscale);相机自己记录在世界坐标系的位置
2. Action Construction(动作构造):
假如说我现在已经有了具有状态的human ego data,那么想要用于训练至少还会需要动作。和机器人数据不同,由于robot data在遥操的时候本质上是控制下发action的命令,但是人在操作的时候无法获得人脑下发的action指令。因此这个时候就需要进行action的构造,常见如下的三种方法:
- state-as-action:直接将下一帧的state作为action target
- Relative Action:将state的变化量作为action
- 直接构造 Robot Action:需要把人类手腕运动映射到机器人末端运动,并考虑坐标轴定义、工具偏移、尺寸差异、机器人工作空间和运动学约束。并且即使完成映射,得到的仍然是机器人关节目标轨迹,能否可靠执行还取决于逆运动学、控制器、接触动力学和实际机械结构。
3. Human-to-Robot Alignment(人机对齐):
由于处理后的数据本质上还要用于训练最后落地到机器人上,那么这里先考虑vla模型的输入,除了没有区别的instruction之外,state action image的对齐似乎都需要考虑
3.1 state
GMR:本质上做的是一个不同机器人之间或者人体数据和机器人之间位姿和状态的映射,已经相对成熟的工作 https://jaraujo98.github.io/retargeting_matters/
3.2 action
这里对于action的映射,我认为效果上来说是先映射状态然后直接在机器人空间中来重构生成action效果应当是优于人类数据分别生成state与action再映射的;这里的一个想法是利用已有的遥操数据的(state,action)训练一个mlp去拟合机型的动作
3.3 image
最简单的来说,如果对于视频不进行转化,那么训练时候的图像中至少面对的是人手,而实际操作的时候观测到的是机械臂,这里至少会存在一个gap。现有的解决方法如下:
- 对齐的人类—机器人数据进行 Mid-training/机器人数据posttrain
- MimicDreamer:尝试直接利用视频生成转化为机器人视频
- Human 原始视频 + Representation Alignment,再适配
但是这几种方法的成本和收益如何,值得探究。
总结一下:3.1和3.2是必须做的工作;而视频数据如何对齐值得考量;如果能将human data无差转化到类robot data,那么数据将可以用于各个训练阶段